Was du hier lernst
- Strings und Indizes
- Modulo-Rechnung
- Brute Force
- Häufigkeitsanalyse
- Dictionaries
- Dateien lesen
- Balkendiagramm zeichnen
So funktioniert die Caesar-Verschlüsselung
Julius Cäsar soll militärische Nachrichten verschlüsselt haben, indem er jeden Buchstaben um drei Stellen im Alphabet verschob: aus A wurde D, aus B wurde E. Wer den Trick kennt, dreht ihn einfach um. Das Programm setzt genau diese Idee um. Danach greift es sein eigenes Verfahren an, zuerst mit roher Gewalt und dann mit Statistik.
1. Ein Alphabet als Zeichenkette
Das Programm braucht einen festen Vorrat an Zeichen, in dem es verschieben kann. Das sind die 26 Kleinbuchstaben und das Leerzeichen:
symbols = "abcdefghijklmnopqrstuvwxyz "
Ein String lässt sich wie eine Liste behandeln. symbols.index("c") liefert die Position 2, symbols[2] liefert umgekehrt wieder das »c«. Mehr Werkzeug braucht die Verschlüsselung nicht.
2. Verschieben mit Modulo
Die Funktion caesar geht den Text Zeichen für Zeichen durch, sucht die Position im Alphabet, addiert den Schlüssel und liest das Zeichen an der neuen Position ab:
index   = symbols.index(letter)
index   = (index + key) % len(symbols)
cipher += symbols[index]
Was passiert am Ende des Alphabets? Das »z« hat den Index 25, plus 4 ergibt 29, und diese Position gibt es nicht. Der Rest der Division durch 27, also % len(symbols), macht daraus eine 2. Das Alphabet verhält sich wie ein Ring: Nach dem Leerzeichen geht es mit »a« weiter.
Zum Entschlüsseln gibt es keine eigene Funktion. caesar(encrypted, -key) schiebt einfach in die andere Richtung zurück.
Modulo mit negativen Zahlen
Beim Entschlüsseln wird der Index oft negativ: »a« (0) minus 4 ergibt −4. In Python liefert -4 % 27 trotzdem 23 und damit das »x«. Das Ergebnis von % hat in Python immer das Vorzeichen des Divisors. In C oder Java käme dagegen −4 heraus, und man müsste selbst korrigieren.
3. Angriff 1: Alle Schlüssel ausprobieren
Die große Schwäche des Verfahrens zeigt schon die Zahl der möglichen Schlüssel: Bei 27 Zeichen gibt es nur 26 sinnvolle Verschiebungen. Ein Computer probiert sie in einem Wimpernschlag durch:
for guess in range(1, len(symbols)):
    print(f"{guess:2}  {caesar(encrypted, -guess)}")
In der Konsole steht danach genau eine Zeile, die nach Deutsch aussieht. Man nennt so einen Angriff Brute Force: Man probiert nicht klug, sondern einfach alles.
4. Die Redundanz der Sprache
Der Computer kann aber auch selbst erkennen, welche Zeile die richtige ist. Das klappt, weil Sprache nicht zufällig ist. Im Deutschen kommt das »e« viel häufiger vor als das »q«, und zwischen den Wörtern stehen Leerzeichen. countLetters aus dem Buch zählt das in einem Auszug aus Goethes »Faust« nach, mit einem Dictionary, das jedem Zeichen seine Anzahl zuordnet:
if character in mydict:
    mydict[character] = mydict.get(character) + 1
else:
    mydict[character] = 1
Das Ergebnis: Das Leerzeichen macht 14,7 Prozent aller Zeichen aus, das »e« 13,8 Prozent, das »n« 8,6 Prozent. Diese ungleiche Verteilung ist ein Fingerabdruck der Sprache.
5. Angriff 2: Die Häufigkeitsanalyse
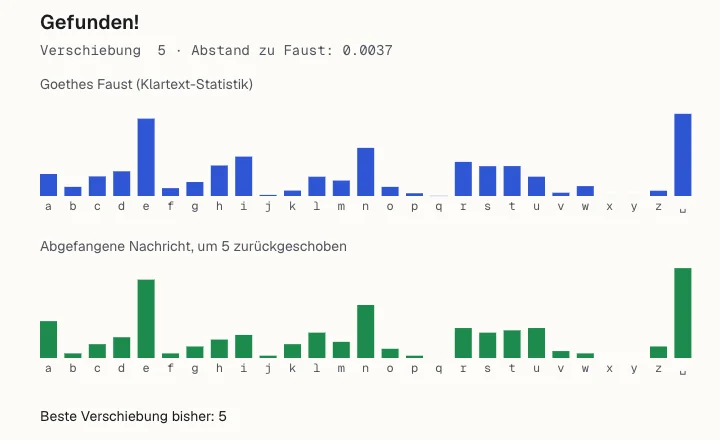
Eine Caesar-Verschlüsselung ändert an diesem Fingerabdruck nichts, sie verschiebt ihn nur. Kommt im Klartext das »e« am häufigsten vor, dann im Geheimtext das Zeichen vier Stellen weiter. Das Programm schiebt die abgefangene Nachricht deshalb probeweise um jede mögliche Verschiebung zurück. Anschließend vergleicht es jeweils die Verteilung mit der Faust-Statistik:
def distance(freqA, freqB):
    return sum((freqA[s] - freqB.get(s, 0)) ** 2 for s in symbols)
distance addiert die quadrierten Unterschiede aller 27 Balken. Passen die Verteilungen gut zusammen, ist die Summe klein. Die Verschiebung mit dem kleinsten Abstand ist der gesuchte Schlüssel. In der Animation siehst du das: Die orangefarbenen Balken rutschen Schritt für Schritt weiter, bis sie wie die blauen aussehen.
Den Schlüssel würfelt das Programm bei jedem Lauf neu aus. Du kannst also mehrmals ausführen, und die Analyse muss ihn jedes Mal wieder finden.
Lszqupmphjf?!
Das Kapitel im Buch trägt diesen seltsamen Titel. Er ist selbst mit Cäsars Verfahren verschlüsselt, mit dem Schlüssel 1. Probier es aus: Hänge print(caesar("lszqupmphjf", -1)) an das Programm an.
6. Wann die Statistik versagt
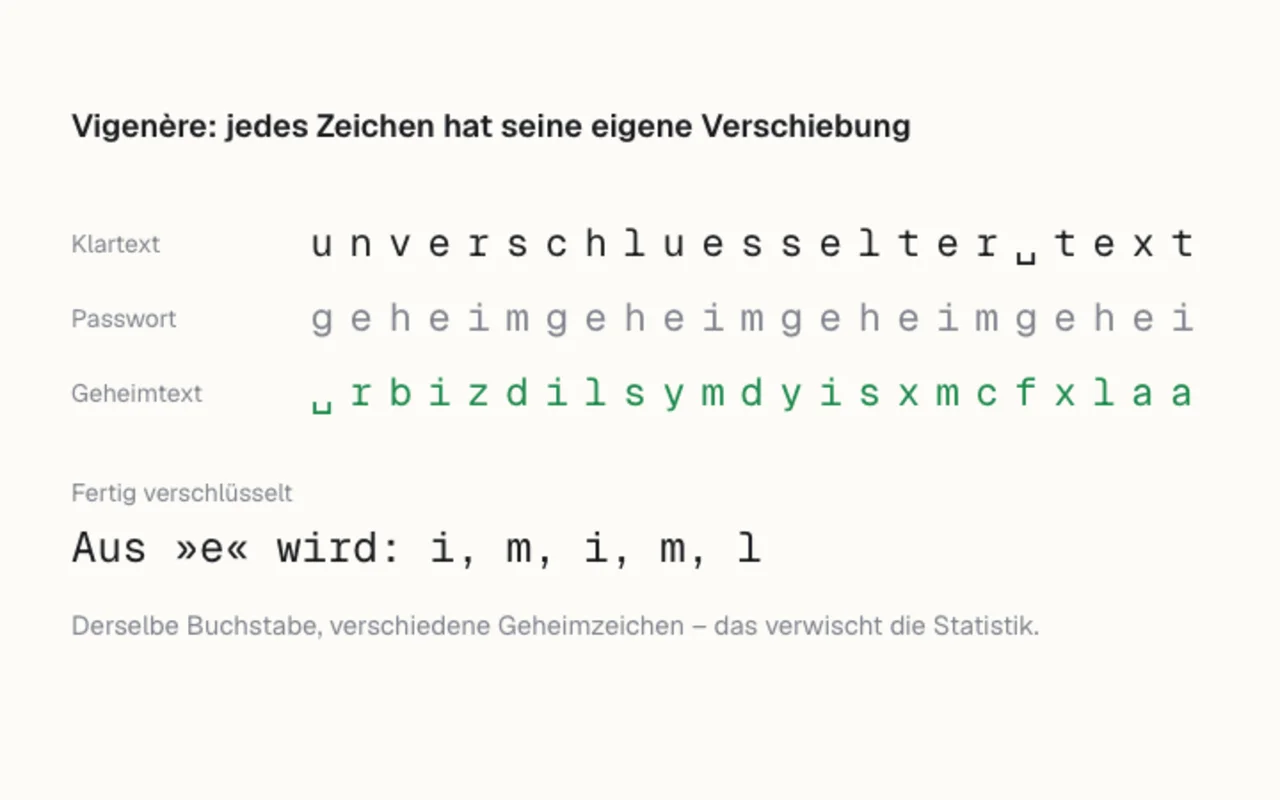
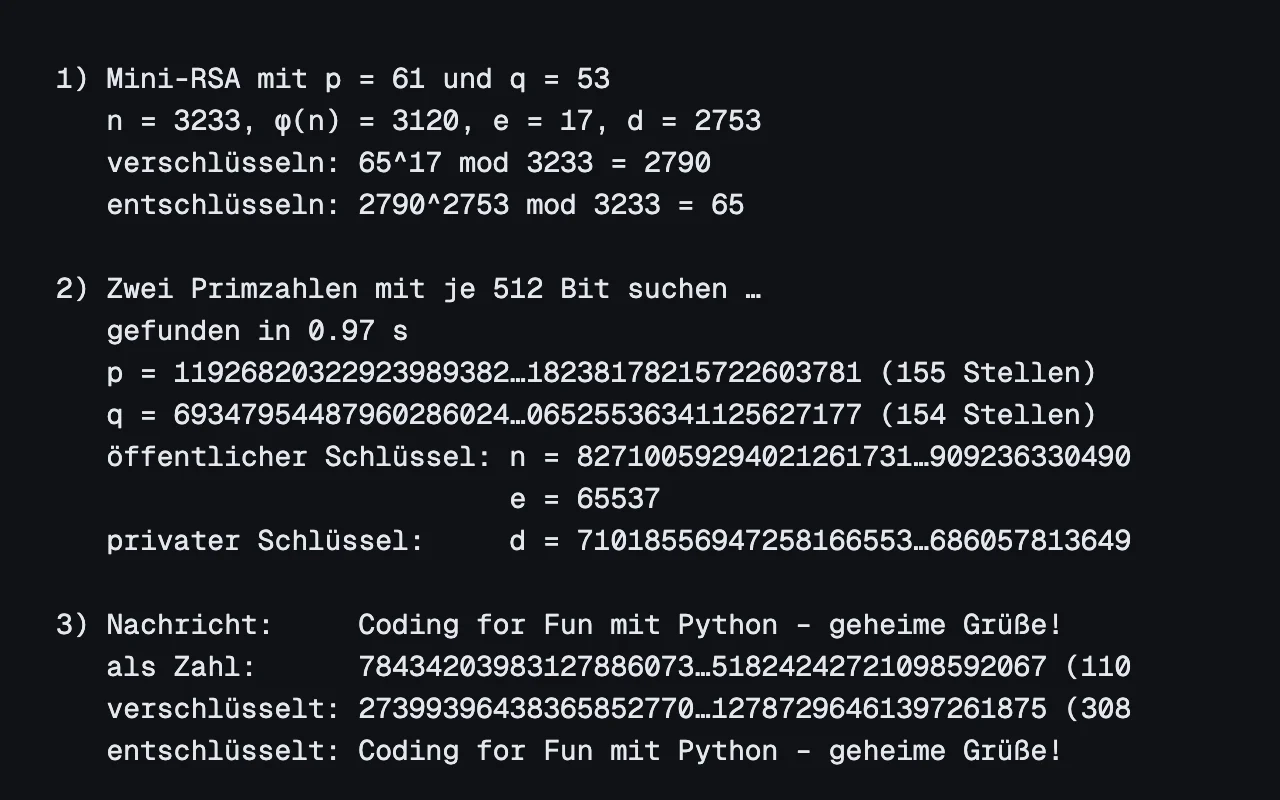
Eine Häufigkeitsanalyse braucht genug Text. In einem Satz wie »Hallo Welt« kommen kaum Buchstaben mehrfach vor, und die Verteilung sieht nach nichts Bestimmtem aus. Das kannst du unter »Probier mal« ausprobieren. Die zweite Grenze ist das Verfahren selbst. Die Vigenère-Verschlüsselung verschiebt jeden Buchstaben um einen anderen Betrag und verwischt damit den Fingerabdruck. Moderne Verfahren wie RSA setzen auf Mathematik, gegen die Zählen nicht mehr hilft.
Probier mal
Jede Variante ändert den Code oben. Ein Klick auf »Ausprobieren« übernimmt die Änderung in den Editor und startet das Programm. »Zurücksetzen« holt das Original zurück.
-
01Ein anderer Schlüssel
Ändere
keyauf einen beliebigen Wert. Weil% len(symbols)den Index immer in den gültigen Bereich zurückholt, funktioniert jede Zahl – auch 100 oder –5. Aber es gibt nur 27 verschiedene Verschiebungen: 31 wirkt genauso wie 4.- key = 4 + key = 13 -
02Deine eigene Geheimbotschaft
Schreib deinen eigenen Text in
message– mit Großbuchstaben, Umlauten und Satzzeichen.normalize()macht daraus einen Text aus Kleinbuchstaben und Leerzeichen, dencaesar()versteht – Ziffern und Satzzeichen fallen dabei weg. Ab etwa zwei Sätzen findet die Häufigkeitsanalyse den Schlüssel zuverlässig.- "Treffpunkt ist morgen um acht Uhr am alten Leuchtturm. Bring die Karte " - "und die Laterne mit, aber erzähle niemandem davon. Wer diese Zeilen " - "lesen kann, hat die Verschlüsselung von Julius Cäsar geknackt – und " - "zwar ganz ohne den Schlüssel zu kennen." + "Python ist eine Programmiersprache, die nach der britischen Komikertruppe " + "Monty Python benannt wurde. Guido van Rossum begann die Entwicklung " + "zum Jahreswechsel 1989/90 – als Hobbyprojekt über die Feiertage." -
03Zu kurz zum Knacken
Statistik braucht Masse. Bei einer Nachricht aus nur zehn Zeichen passt die Häufigkeitsverteilung zu keinem Schlüssel wirklich – die Analyse rät dann meistens falsch. Angriff 1, das stumpfe Ausprobieren aller Schlüssel, funktioniert dagegen immer.
- "Treffpunkt ist morgen um acht Uhr am alten Leuchtturm. Bring die Karte " - "und die Laterne mit, aber erzähle niemandem davon. Wer diese Zeilen " - "lesen kann, hat die Verschlüsselung von Julius Cäsar geknackt – und " - "zwar ganz ohne den Schlüssel zu kennen." + "Hallo Welt" -
04Die ganze Statistik
Statt der sechs häufigsten Zeichen gibt das Programm jetzt alle aus – genau wie
statistics.pyim Buch. Das Leerzeichen liegt knapp vor dem »e«, am Ende der Liste stehen »q«, »x« und »y«.- for letter, count in letterList[:6]: + for letter, count in letterList: -
05Die Skytale von Sparta
Die Skytale ist noch älter als Cäsars Verfahren. Sie ersetzt keine Buchstaben, sondern vertauscht ihre Reihenfolge: Der Text wurde auf einen Lederstreifen geschrieben, der um einen Stab gewickelt war. Nur wer einen Stab mit demselben Umfang besaß, konnte ihn wieder lesen. Die Variante hängt die Skytale an den ersten Teil an.
- print(plaintext)
- print(encrypted)
- print(decrypted)
+ print(plaintext)
+ print(encrypted)
+ print(decrypted)
+
+
+ # Die Skytale von Sparta: vertauschen statt ersetzen
+ def skytale_encrypt(text, umfang):
+     while len(text) % umfang != 0:  # auffüllen, bis es aufgeht
+         text += " "
+     cipher = ""
+     for x in range(0, umfang):
+         for y in range(x, len(text), umfang):
+             cipher += text[y]
+     return cipher.upper()
+
+
+ def skytale_decrypt(text, umfang):
+     return skytale_encrypt(text, len(text) // umfang).lower()
+
+
+ skytale = skytale_encrypt("heute ist sehr schoenes wetter", 8)
+ print()
+ print("Skytale:", skytale)
+ print("zurück: ", skytale_decrypt(skytale, 8))
Vom Buch in den Browser
Im Buch sind Verschlüsselung und Statistik zwei getrennte Python-2-Programme: caesar.py verschlüsselt und entschlüsselt einen Satz, statistics.py zählt die Buchstaben in Goethes »Faust«. Hier sind beide in einer Datei zusammengeführt. Die Funktionen caesar() und countLetters() stammen aus dem Buch. Neu für die Website sind das Durchprobieren aller Schlüssel, der automatische Angriff mit frequencies() und distance(), die Hilfsfunktion normalize() und das Diagramm.
Die Änderungen für Python 3:
printist eine Funktion:print plaintextwird zuprint(plaintext). Für die Tabellen kommen f-Strings wief"{guess:2}"dazu.mydict.has_key(character)gibt es nicht mehr. Stattdessen heißt escharacter in mydict.mydict.items()liefert in Python 3 eine Ansicht statt einer Liste.list(...)macht wieder eine Liste daraus.- Die Originaldateien sind in Latin-1 gespeichert (
#coding: latin1). Python 3 arbeitet mit Unicode, und die Datei wird ausdrücklich mitencoding="utf-8"geöffnet. countLetterszählt hier auch das Leerzeichen mit, weil es zum Alphabet voncaesar()gehört. Im Buch ging es nur um die 26 Buchstaben.
Im Buch wertet statistics.py drei Dateien aus: die beiden Teile des »Faust« und eine mit 7-Zip komprimierte Fassung. In einer komprimierten Datei sind die Zeichen nahezu gleich verteilt, denn Kompression entfernt genau die Redundanz, von der die Häufigkeitsanalyse lebt. Nebenbei: Das Original teilt alle drei Spalten durch die Zeichenzahl der zweiten Datei (letterCount2), dadurch sind die Prozentwerte der anderen Spalten leicht verzerrt. Hier gibt es nur eine Datei, einen Auszug aus »Faust I«. Der Browser legt sie vor dem Start in ein virtuelles Dateisystem, sodass open("faust.txt") wie auf dem Desktop funktioniert.
Die Animation braucht, wie alle Programme dieser Website, ein await screen.frame(6): Damit zeigt der Browser das aktuelle Diagramm an und wartet bis zum nächsten Bild, sechs Mal pro Sekunde.
Original aus dem Buch ansehen caesar.py · Python 2
#coding: latin1

def caesar(text, key):
    cipher = ""
    for letter in text:
        # Index des aktuellen Klartextbuchstaben
        # im Symbolvorrat bestimmen
        index   = symbols.index(letter)
        # Addition des Schlüssels zum Index und Sicherstellung,
        # dass der Index im gültigen Bereich bleibt
        index   = (index + key) % len(symbols)
        cipher += symbols[index]

    return cipher

key         = 4
symbols     = "abcdefghijklmnopqrstuvwxyz "
plaintext   = "diese nachricht kann im prinzip jeder knacken"

encrypted = caesar(plaintext,  key)
decrypted = caesar(encrypted, -key)

print plaintext
print encrypted
print decrypted
Original aus dem Buch ansehen statistics.py · Python 2
import operator

def countLetters(fileName):
    # festlegen der für die
    # Statistik relevanten Zeichen
    letters = "abcdefghijklmnopqrstuvwxyz"
    mydict  =   {}
    # öffnen der Datei, welche
    # statistisch ausgewertet werden soll
    fobj    =   open(fileName, "r")
    counter = 0

    for line in fobj:
        for character in line:
            # keine Unterscheidung von Groß-
            # und Kleinbuchstaben notwendig
            character = character.lower()
            if character in letters:
                # Anzal eingelesener Buchstaben
                # um eins erhöhen
                counter += 1
                # Buchstabe wurde schonmal gelesen
                if mydict.has_key(character) == 1:
                    mydict[character]=mydict.get(character)+1
                # erstes Auftreten des Buchstaben
                else:
                    mydict[character]=1

    fobj.close()

    # Umwandlung des Dictionary in eine
    # Liste um die Sortierung zu ermöglichen
    letterList = mydict.items()
    # Sortierung der Liste anhand der
    # Häufigkeit des Auftretens der Buchstaben
    letterList = sorted(letterList, key=operator.itemgetter(1), reverse=True)

    return counter, letterList


letterCount1, letterList1 = countLetters("FaustTrag1.txt")
letterCount2, letterList2 = countLetters("FaustTrag2.txt")
letterCount3, letterList3 = countLetters("GoethePPmd.7z")

allLists = zip(letterList1, letterList2, letterList3)

for letterList in allLists:
    for entry in letterList:
        print entry[0]+" -> "+str(float(entry[1])/letterCount2*100)+"\t",
    print
Original aus dem Buch ansehen skytale.py · Python 2
#coding: latin1

# stellt sicher, dass die Länge des Textes ohne Rest durch den Umfang teilbar ist
def ensureSideCondition(text, umfang):
    length      = len(text)
    remainder   = length % umfang
    while remainder != 0:
        text       += " "
        length      = len(text)
        remainder   = length % umfang

    return text

def skytale_encrypt(text, umfang):
    text    = ensureSideCondition(text, umfang)
    length  = len(text)
    cipher  = ""
    for x in range(0, umfang):
        for y in range(x, length, umfang):
            cipher += text[y]

    return cipher.upper()

def skytale_decrypt(text, umfang):
    length      = len(text)
    umfang      = length/umfang
    plaintext   = skytale_encrypt(text, umfang)

    return plaintext.lower()

key         = 8
plaintext   = "heute ist sehr schönes wetter"
cipher      = skytale_encrypt(plaintext, key)

print plaintext
print cipher
print skytale_decrypt(cipher, key)