Was du hier lernst
- Spielbaum und Rekursion
- Minimax und NegaMax
- Alpha-Beta-Suche
- NegaScout (Principal Variation Search)
- Zugsortierung
- Vererbung
- Laufzeit messen
Die Erklärung stammt – leicht überarbeitet für Python 3 – aus dem Buch „Coding for Fun mit Python“ von Lars Heppert, Kapitel 6, Abschnitte 6.3 und 6.6; Messungen und Fehlerkorrekturen sind neu.
Vier Wege durch den Spielbaum
Im Kapitel über Tic Tac Toe spielt der Computer perfekt, weil er jede Partie bis zum Ende vorausberechnet. Die Suchverfahren dafür haben sich schrittweise weiterentwickelt: vom Minimax-Algorithmus über NegaMax zum Alpha-Beta-Pruning und weiter zu NegaScout. Auf der Buch-CD lagen sie als einzelne »Tuning-Stufen« nebeneinander. Hier treten die vier gegeneinander an – auf denselben Stellungen, mit Stoppuhr und Zähler.
Der Spielbaum
Jede Stellung ist ein Knoten im Baum, jeder mögliche Zug eine Kante zur nächsten Stellung. Vom leeren Brett gehen neun Kanten aus, von jeder dieser Stellungen acht, und so weiter. Ohne vorzeitige Siege gäbe es 9! = 362.880 Spielverläufe. Weil viele Partien früher enden, sind es tatsächlich 255.168 verschiedene Partien – und 549.945 Stellungen, die man besuchen muss, um sie alle zu sehen.
Das Durchlaufen eines Baums, bei dem jeder Knoten besucht wird, heißt Traversierung. Jedes Verfahren auf dieser Seite zählt in self.nodes mit, wie viele Knoten es tatsächlich besucht. Das ist ein ehrlicheres Maß als die Zeit, denn die hängt vom Rechner und vom Browser ab.
Minimax: zwei Funktionen, die sich abwechseln
Minimax wählt den Zug mit der höchsten Bewertung, wenn Spieler 1 am Zug ist, und den mit der niedrigsten, wenn Spieler 2 dran ist. Dafür gibt es zwei Methoden, die sich gegenseitig aufrufen:
for move in moves:
    self.gameObject.makeMove(move)
    value = self.min(depth - 1)
    self.gameObject.undoMove(move)
    if value > alpha:
        alpha = value
Das ist der Kern von max(). min() ist dasselbe mit umgedrehtem Vergleich. Minimax schaut sich immer den kompletten Baum an: 549.945 Stellungen auf dem leeren Brett.
NegaMax: eine Funktion für beide
Schon im Buch fällt auf, wie ähnlich sich max() und min() sind. Das Maximieren des negierten Werts entspricht dem Minimieren des Werts. Wenn jede Stellung aus Sicht dessen bewertet wird, der gerade am Zug ist, reicht eine einzige Funktion – das Minuszeichen dreht die Sicht bei jeder Ebene um:
value = -self.explore(depth - 1)
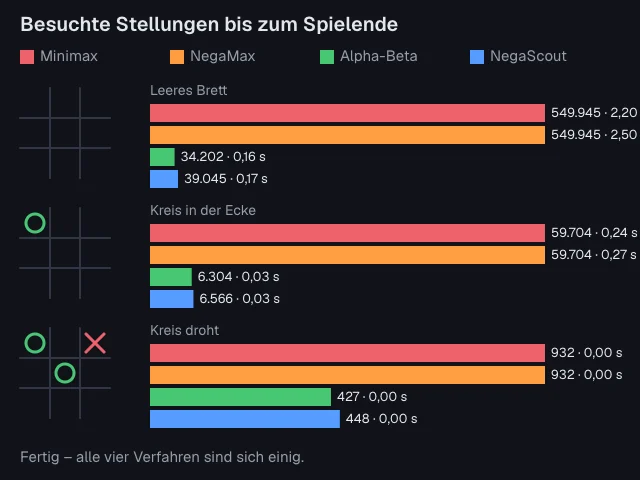
Damit das klappt, muss auch die Bewertung am Blatt aus der richtigen Sicht kommen. evaluate() bewertet immer aus Sicht von Spieler 1; ist Spieler 2 am Zug, dreht explore() das Vorzeichen um. Die Messung zeigt: NegaMax besucht exakt so viele Stellungen wie Minimax. Es spart Code, keine Arbeit.
Alpha-Beta: Äste abschneiden
Den eigentlichen Fortschritt bringt das Alpha-Beta-Pruning. Dabei werden Äste abgetrennt, deren Züge zu schlechteren Stellungen führen als der bisher beste Zug. Dafür bekommt explore() zwei Grenzen mit: alpha ist der Wert, den ich mir schon sicher erspielen kann, beta der Wert, den mein Gegner mir höchstens zugesteht. Zusammen bilden sie das Suchfenster, die Spannweite der Bewertungen, die noch interessant sind.
if value >= beta:
    # beta-»cut off«
    return beta
if value > alpha:
    alpha = value
Findet die Suche einen Zug, der mindestens beta bringt, kann sie aufhören: Der Gegner würde es gar nicht zu dieser Stellung kommen lassen, weil er vorher eine bessere Alternative hatte. Die restlichen Züge muss niemand mehr ansehen. Beim Abstieg in die nächste Ebene wechselt die Sicht zum Gegner, deshalb wird das Fenster gespiegelt: Aus (alpha, beta) wird (-beta, -alpha).
Das Ergebnis ist beeindruckend: Alpha-Beta kommt zu genau denselben Bewertungen wie Minimax, besucht auf dem leeren Brett aber nur 34.202 statt 549.945 Stellungen – rund ein Sechzehntel.
Der Fehler auf der Buch-CD
Die Datei alphbetaprunning.py von der Buch-CD hätte so nie laufen können. Zwei Fehler steckten darin:
- Der Standardwert in der Parameterliste. Dort stand
alpha = -AlphaBetaPrunning.infinity. Standardwerte wertet Python aus, während es den Klassenkörper ausführt – und in diesem Moment gibt es den Namen der Klasse noch nicht. Ergebnis: einNameError, schon beim Importieren. Hier erbt die Klasse vonNegaMaxund schreibt-NegaMax.infinity. Die Elternklasse existiert zu diesem Zeitpunkt bereits. - Das vertauschte Fenster. Der rekursive Aufruf lautete
-self.explore(depth - 1, -alpha, -beta). Damit steht das Fenster auf dem Kopf: Die untere Grenze liegt über der oberen, fast jeder Zug löst sofort einen Schnitt aus, und die Bewertungen sind Unsinn.
Den zweiten Fehler kannst du unter »Probier mal« wieder einbauen. Die Prüfung am Ende des Programms vergleicht die Bewertungen aller Züge und schlägt Alarm, sobald ein Verfahren von Minimax abweicht. Genau solche Vergleiche mit einer langsamen, aber sicheren Referenz sind der beste Test für schnelle Suchverfahren.
NegaScout: mit dem Mini-Fenster vorfühlen
Eine weitergehende Optimierung verkleinert das Suchfenster, ohne auf die Auswertung der Züge zu warten. NegaScout – auch Principal Variation Search genannt – bewertet den ersten Zug mit dem vollen Fenster. Jeden weiteren Zug prüft er nur mit einem Fenster der Breite 1:
if pvFound:
    # suche mit kleinem Fenster starten
    value = -self.explore(depth - 1, -alpha - 1, -alpha)
    if value > alpha and value < beta:
        # neue Hauptvariante gefunden,
        # Suchlauf ist deshalb zu wiederholen
        value = -self.explore(depth - 1, -beta, -alpha)
Das schmale Fenster beantwortet nur die Frage »Ist dieser Zug besser als der bisher beste?« – und das geht schnell, weil fast alles abgeschnitten wird. Lautet die Antwort Ja, war der Zug voreilig aussortiert, und die Suche wird mit dem vollen Fenster wiederholt.
Im Buch heißt es dazu: Diese Optimierung ergibt nur Sinn, wenn Neubewertungen selten nötig sind. Sind sie an der Tagesordnung, ist NegaScout sogar langsamer. Die Messung bestätigt das: Auf dem leeren Brett besucht NegaScout 39.045 Stellungen, mehr als Alpha-Beta. Die Züge kommen hier in der Reihenfolge des Bretts dran, von links oben nach rechts unten – und damit muss NegaScout allein auf dem leeren Brett 145-mal neu suchen.
Gute Züge zuerst
Voraussetzung für den größten Vorteil ist, die Züge zu sortieren: Die laut Heuristik vermutlich besten Züge sollten zuerst bewertet werden. Bei Tic Tac Toe ist das leicht – die Mitte ist fast immer stark, danach kommen die Ecken. Mit dieser Sortierung (Variante »Gute Züge zuerst«) sinken die Zahlen auf dem leeren Brett deutlich:
| Verfahren | Brett-Reihenfolge | Mitte, Ecken, Ränder |
|---|---|---|
| Minimax | 549.945 | 549.945 |
| NegaMax | 549.945 | 549.945 |
| Alpha-Beta | 34.202 | 16.553 |
| NegaScout | 39.045 | 14.405 |
Jetzt überholt NegaScout das Alpha-Beta-Verfahren, und auf dem leeren Brett sinkt die Zahl der Neusuchen von 145 auf 46. Minimax und NegaMax interessiert die Reihenfolge nicht – sie schauen sich ohnehin alles an.
Messen statt raten
compare() baut für jedes Verfahren ein frisches Spiel auf, stoppt die Zeit mit time.perf_counter() und rechnet alle Bewertungen in dieselbe Sicht um. Das ist nötig, weil Minimax aus Sicht von Spieler 1 bewertet, die drei Nega-Verfahren dagegen aus Sicht des Gegners nach dem Zug:
if searchClass is MiniMax:
    value = value if side == 1 else -value   # MiniMax: Sicht von Spieler 1
else:
    value = -value                           # Nega…: Sicht des Gegners
Die Zeiten schwanken von Lauf zu Lauf und von Rechner zu Rechner. Die Zahl der Stellungen bleibt dagegen immer gleich. Deshalb vergleicht man Suchverfahren in der Forschung am liebsten über die besuchten Knoten.
Und im Schach?
Schachprogramme arbeiten mit denselben Bausteinen: Alpha-Beta beziehungsweise NegaScout, möglichst gute Zugsortierung und dazu Zwischenspeicher für bereits bewertete Stellungen. Weil sich Schach nicht bis zum Ende durchrechnen lässt, kommt eine gute Bewertungsfunktion hinzu. Einen Einblick, wie die Schach-KI DeepSquare sucht und bewertet, gibt es auf der Forschungsseite des Projekts.
Probier mal
Jede Variante ändert den Code oben. Ein Klick auf »Ausprobieren« übernimmt die Änderung in den Editor und startet das Programm. »Zurücksetzen« holt das Original zurück.
-
01Gute Züge zuerst
Das Buch betont: Alpha-Beta und NegaScout sparen am meisten, wenn die vermutlich besten Züge zuerst drankommen. Bei Tic Tac Toe ist die Mitte fast immer stark, danach die Ecken. Sortiere die Züge so – und schau, wie die grünen und blauen Balken schrumpfen, während Minimax gleich viel rechnen muss.
- for y in range(3): - for x in range(3): - if self.field[y][x] == 0: - moves.append((x, y)) + # erst die Mitte, dann die Ecken, zuletzt die Ränder + for x, y in [(1, 1), (0, 0), (2, 0), (0, 2), (2, 2), + (1, 0), (0, 1), (2, 1), (1, 2)]: + if self.field[y][x] == 0: + moves.append((x, y)) -
02Der Fehler von der Buch-CD
In
alphbetaprunning.pyauf der Buch-CD stand der rekursive Aufruf mit vertauschten Grenzen:-alpha, -betastatt-beta, -alpha. Dann ist das Suchfenster verkehrt herum, fast jeder Zug löst sofort einen Schnitt aus – und die Bewertungen sind Unsinn. Die Prüfung am Ende schlägt Alarm.- # aus Sicht des Gegners: aus (alpha, beta) wird (-beta, -alpha) - value = -self.explore(depth - 1, -beta, -alpha) + # so stand es auf der Buch-CD: die Grenzen vertauscht + value = -self.explore(depth - 1, -alpha, -beta) -
03Wie oft sucht NegaScout neu?
NegaScout prüft jeden weiteren Zug erst mit einem winzigen Fenster. Stellt sich der Zug doch als besser heraus, muss die Suche mit dem vollen Fenster wiederholt werden. Ein Klassenattribut zählt diese Wiederholungen über alle Stellungen zusammen. Probiere die Variante auch zusammen mit »Gute Züge zuerst«: Dann sind es nur noch etwa halb so viele.
- class NegaScout(NegaMax): - # getEvaluatedMoves erbt die Klasse von NegaMax + class NegaScout(NegaMax): + # getEvaluatedMoves erbt die Klasse von NegaMax + researches = 0 # so oft musste NegaScout neu suchen - # Suchlauf ist deshalb zu wiederholen - value = -self.explore(depth - 1, -beta, -alpha) + # Suchlauf ist deshalb zu wiederholen + NegaScout.researches += 1 + value = -self.explore(depth - 1, -beta, -alpha) - print("\nAlle vier Verfahren kommen zu denselben Bewertungen:", "ja" if agree else "NEIN") + print("\nNegaScout musste", NegaScout.researches, "Mal mit vollem Fenster neu suchen.") + print("\nAlle vier Verfahren kommen zu denselben Bewertungen:", "ja" if agree else "NEIN") -
04Eine Stellung mit Sieg
Kreis in einer Ecke, Kreuz in der gegenüberliegenden: Jetzt kann Kreis den Sieg erzwingen, mit einer Zwickmühle aus zwei Drohungen. Die Bewertung ist deshalb nicht mehr 0, sondern positiv: 10 plus die Zahl der Felder, die beim Sieg noch frei sind. Zeichen:
Ofür Kreis,Xfür Kreuz,.für ein freies Feld.- ("Kreis droht", "O.X.O....")] + ("Kreis droht", "O.X.O...."), + ("Kreis gewinnt", "O.......X")] -
05Merken statt zählen
Eine der Tuning-Stufen von der Buch-CD:
getSide()zählt bei jedem Aufruf alle neun Felder, um herauszufinden, wer am Zug ist. Schneller geht es, wenn sich das Spiel den Spieler insideToPlaymerkt und bei jedem Zug umschaltet. Die Zahl der Stellungen bleibt gleich – vergleiche die Zeiten.- self.field[i // 3][i % 3] = ".OX".index(sign) + self.field[i // 3][i % 3] = ".OX".index(sign) + # bei einer geraden Zahl von Steinen ist Kreis am Zug + self.sideToPlay = 1 if position.count(".") % 2 == 1 else 2 - def getSide(self): - count = 0 - for y in range(3): - for x in range(3): - if self.field[y][x] != 0: - count += 1 - - if count % 2 == 0: - return 1 - return 2 - - @property - def sideToPlay(self): - return self.getSide() + def getSide(self): + # merken statt zählen: sideToPlay wechselt bei jedem Zug + return self.sideToPlay - def makeMove(self, move): - x, y = move - self.field[y][x] = self.getSide() - - def undoMove(self, move): - x, y = move - self.field[y][x] = 0 + def makeMove(self, move): + x, y = move + self.field[y][x] = self.sideToPlay + self.sideToPlay = 3 - self.sideToPlay + + def undoMove(self, move): + x, y = move + self.field[y][x] = 0 + self.sideToPlay = 3 - self.sideToPlay
Vom Buch in den Browser
Die vier Suchklassen stammen aus verschiedenen Quellen. MiniMax folgt den gedruckten Listings 6.1 bis 6.5, NegaScout Listing 6.21. NegaMax kommt von der Buch-CD (Kapitel06/tuning1/negamax.py), AlphaBetaPruning aus tuning4_treeSearch/alphbetaprunning.py. Das Spiel selbst ist die Klasse TicTacToe aus Listing 6.25 bis 6.27. Für den Vergleich wurde einiges vereinheitlicht:
| Buch und CD | Hier |
|---|---|
jede Klasse mit eigener Kopie von getEvaluatedMoves() |
AlphaBetaPruning und NegaScout erben sie von NegaMax |
treeNodeCounter zählt nur innere Knoten |
self.nodes zählt jede besuchte Stellung, auch die Blätter |
alpha = -AlphaBetaPrunning.infinity in der Parameterliste |
alpha=-NegaMax.infinity (die Elternklasse existiert schon) |
-self.explore(depth-1, -alpha, -beta) |
-self.explore(depth - 1, -beta, -alpha) |
sideToPlay nur in der Tuning-Stufe 3 |
Property, die getSide() aufruft |
| Brett startet immer leer | TicTacToe("O.X.O....") lädt eine beliebige Stellung |
print 'best move = ', bestMove |
Tabelle in der Konsole, Balkendiagramm auf der Leinwand |
Einige Details:
- Richtige Schreibweise: Die Klasse heißt jetzt
AlphaBetaPruningstattAlphaBetaPrunning. Der Dateiname auf der CD,alphbetaprunning.py, hatte sogar zwei Tippfehler. - Tuning-Stufen: Auf der CD lagen vier getunte Fassungen des Spiels. Stufe 1 schaltete psyco ein, einen Just-in-time-Compiler für Python 2, den es für Python 3 nicht mehr gibt. Stufe 2 legte
range(3)nur einmal an und durchlief das Brett teilweise direkt statt über Indizes. Stufe 3 merkte sich den Spieler am Zug insideToPlay, statt ihn zu zählen – das kannst du unter »Probier mal« ausprobieren –, und wählte unter gleich guten Zügen zufällig. Stufe 4 brachte die neuen Suchverfahren. - Profiling: Die CD enthielt auch
profiling.py, das die Suche mit den Modulenprofileundpstatsvermaß. Hier genügttime.perf_counter(), und die Zahl der Stellungen ist ohnehin das aussagekräftigere Maß. - Perspektive:
compare()rechnet alle Bewertungen in die Sicht des Spielers um, der in der Stellung am Zug ist. Erst dadurch lassen sich Minimax und die Nega-Verfahren direkt vergleichen. - Zeichnen zwischendurch: Vor jeder Suche zeichnet das Programm den Zwischenstand und wartet mit
await screen.frame()einen Bildwechsel ab. Während einer Suche selbst steht die Anzeige still.
Original aus dem Buch ansehen minimax.py · Python 2
class MiniMax(object):
    infinity = 200

    def __init__(self, gameObject):
        self.gameObject = gameObject

    def getEvaluatedMoves(self, depth):
        possibleMoves   = self.gameObject.getMoves()
        evaluatedMoves  = []
        for move in possibleMoves:
            self.gameObject.makeMove(move)
            evaluation = self.explore(depth)
            self.gameObject.undoMove(move)
            evaluatedMoves.append((evaluation, move))

        evaluatedMoves.sort()
        return evaluatedMoves

    def explore(self, depth):
        if self.gameObject.getSide() == 1:
            return self.max(depth)
        else:
            return self.min(depth)

    def max(self, depth):
        alpha = -MiniMax.infinity
        moves = self.gameObject.getMoves()

        if depth <= 0 or not moves:
            return self.gameObject.evaluate()

        for move in moves:
            self.gameObject.makeMove(move)
            value = self.min(depth-1)
            self.gameObject.undoMove(move)
            if value > alpha:
                alpha = value

        return alpha

    def min(self, depth):
        alpha = MiniMax.infinity
        moves = self.gameObject.getMoves()

        if depth <= 0 or not moves:
            return self.gameObject.evaluate()

        for move in moves:
            self.gameObject.makeMove(move)
            value = self.max(depth-1)
            self.gameObject.undoMove(move)
            if value < alpha:
                alpha = value

        return alpha
Original aus dem Buch ansehen negamax.py · Python 2
'''
Created on 14.04.2009

@author: Lars Heppert
'''

class NegaMax(object):
#   the evaluation function has to be smaller
#   than the defined infinity value
    infinity = 200

    def __init__(self, gameObject):
        self.gameObject = gameObject

    def getEvaluatedMoves(self, depth):
        possibleMoves   = self.gameObject.getMoves()
        evaluatedMoves  = []
        for move in possibleMoves:
            self.gameObject.makeMove(move)
            self.treeNodeCounter = 0
            evaluation = self.explore(depth-1)
            self.gameObject.undoMove(move)
            evaluatedMoves.append((evaluation, move, self.treeNodeCounter))

        evaluatedMoves.sort()
        return evaluatedMoves

    def getBestMove(self, depth):
        moves = self.getEvaluatedMoves(depth)
        print '\nEvaluated Moves:'
        for move in moves:
            print move
        print '----------------'
        bestMove = moves[0][1]
        print 'best move = ', bestMove
        return bestMove

    def explore(self, depth):
        alpha = -NegaMax.infinity
        moves = self.gameObject.getMoves()

        if depth <= 0 or not moves:
            if self.gameObject.getSide() == 1:
                return +self.gameObject.evaluate()
            else:
                return -self.gameObject.evaluate()

        self.treeNodeCounter += 1
        for move in moves:
            self.gameObject.makeMove(move)
            value = -self.explore(depth-1)
            self.gameObject.undoMove(move)
            if value > alpha:
                alpha = value

        return alpha
Original aus dem Buch ansehen alphbetaprunning.py · Python 2
'''
Created on 19.04.2009

@author: Lars Heppert
'''

class AlphaBetaPrunning(object):
#   the evaluation function has to be smaller
#   than the defined infinity value
    infinity = 200

    def __init__(self, gameObject):
        self.gameObject = gameObject

    def getEvaluatedMoves(self, depth):
        possibleMoves   = self.gameObject.getMoves()
        evaluatedMoves  = []
        for move in possibleMoves:
            self.gameObject.makeMove(move)
            self.treeNodeCounter = 0
            evaluation = self.explore(depth-1)
            self.gameObject.undoMove(move)
            evaluatedMoves.append((evaluation, move, self.treeNodeCounter))

        evaluatedMoves.sort()
        return evaluatedMoves

    def getBestMove(self, depth):
        moves = self.getEvaluatedMoves(depth)
        print '\nEvaluated Moves:'
        for move in moves:
            print move
        print '----------------'
        bestMove = moves[0][1]
        print 'best move = ', bestMove
        return bestMove

    def explore(self, depth,
                alpha   =   -AlphaBetaPrunning.infinity,
                beta    =   +AlphaBetaPrunning.infinity):

        moves = self.gameObject.getMoves()
        if depth <= 0 or not moves:
            if self.gameObject.sideToPlay == 1:
                return +self.gameObject.evaluate()
            else:
                return -self.gameObject.evaluate()

        self.treeNodeCounter += 1
        for move in moves:
            self.gameObject.makeMove(move)
            value = -self.explore(depth-1, -alpha, -beta)
            self.gameObject.undoMove(move)
            if value >= beta:
#               beta cut off
                return beta
            if value > alpha:
                alpha = value

        return alpha
Original aus dem Buch ansehen negaScout.py · Python 2
'''
Created on 19.04.2009

@author: Lars Heppert
'''

class NegaScout(object):
#   the evaluation function has to be smaller
#   than the defined infinity value
    infinity    = 200

    def __init__(self, gameObject):
        self.gameObject = gameObject

    def getEvaluatedMoves(self, depth):
        possibleMoves   = self.gameObject.getMoves()
        evaluatedMoves  = []
        for move in possibleMoves:
            self.gameObject.makeMove(move)
            self.treeNodeCounter = 0
            evaluation = self.explore(depth-1)
            self.gameObject.undoMove(move)
            evaluatedMoves.append((evaluation, move, self.treeNodeCounter))

        evaluatedMoves.sort()
        return evaluatedMoves

    def getBestMove(self, depth):
        moves = self.getEvaluatedMoves(depth)
        print '\nEvaluated Moves:'
        for move in moves:
            print move
        print '----------------'
        bestMove = moves[0][1]
        print 'best move = ', bestMove
        return bestMove

    def explore(self, depth,
                alpha   =   -infinity,
                beta    =   +infinity):

        moves = self.gameObject.getMoves()
        if depth <= 0 or not moves:
            if self.gameObject.getSide() == 1:
                return +self.gameObject.evaluate()
            else:
                return -self.gameObject.evaluate()

        pvFound = False
        self.treeNodeCounter += 1
        for move in moves:
            self.gameObject.makeMove(move)
            if pvFound:
#               search with small window
                value = -self.explore(depth-1, -alpha-1, -alpha)
                if value > alpha and value < beta:
#                   new principal variation found -> research necessary
                    value = -self.explore(depth-1, -beta, -alpha)
            else:
                value = -self.explore(depth-1, -beta, -alpha)
            self.gameObject.undoMove(move)

            if value >= beta:
#               beta cut off
                return beta

            if value > alpha:
                alpha = value
                pvFound = True

        return alpha